L'IA battuta dagli umani in un difficile test di matematica
 Woody Allen, satira e curiosità tra cinema, animali e cultura popolare
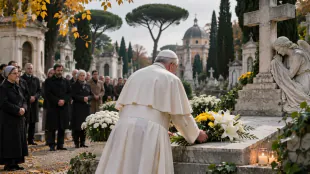 Il Papa al Verano richiama i potenti davanti alle sofferenze delle guerre
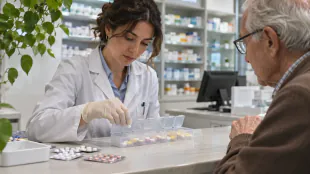 Farmaci confezionati per il singolo paziente, la legge apre il nodo dei costi
 Memorial Ronchi, Seregno vince il Gold e Garbagnate conquista il Silver
 Demolizione di San Siro, prosegue il confronto sul futuro dell’area
 Milano, il bilocale guida la domanda immobiliare con il 44,7 per cento
 Antonelli campione del mondo, una stagione costruita senza ambiguità
 Mercati europei in calo per tensioni Iran-Midterm e risultati tech
 Tensione in una moschea di Modena durante un servizio di Fuori dal Coro
 Cyberattacco ai sistemi frigoriferi dei supermercati, colpita anche l’Italia
Messi alla prova 4 modelli tra cui ChatGpt, il risultato migliore è stato 6 quesiti su 10
L'Intelligenza Artificiale è stata battuta dagli esseri umani nel più difficile e rigoroso test di matematica al quale è stata sottoposta finora: sono stati messi alla prova quattro diversi modelli, tra cui ChatGpt 5.5 Pro, e nessuno di loro è riuscito a rispondere correttamente a tutti e 10 i quesiti. Il risultato migliore, come riporta la rivista Nature sul suo sito, lo ha ottenuto il modello del Politecnico Federale di Zurigo (Eth), che ha risolto 6 problemi su 10. ChatGpt di OpenAI è arrivato terzo dietro il modello dell'Università della California a Los Angeles, mentre si è classificato ultimo quello dell'Università di Princeton, che a differenza degli altri si basava su Gemini di Google. Il test fa parte di First Proof, il progetto indipendente promosso per seguire l'evoluzione delle capacità dell'intelligenza artificiale nella ricerca matematica, che pubblica i risultati sul suo sito. Le domande poste nell'esame non erano mai state pubblicate prima né nella letteratura scientifica né su Internet, per ridurre il rischio che i modelli si limitassero a ripetere informazioni apprese durante l'addestramento. Un gruppo di 30 matematici ha poi verificato le risposte. Un'altra regola prevedeva che i modelli partecipanti dovessero essere disponibili al grande pubblico e questo ha fatto sì che OpenAI sia stata l'unica grande azienda a prendere parte al test. Due degli altri tre modelli partecipanti si basavano comunque su ChatGpt, grazie a sistemi automatici nei quali le risposte date da questo modello linguistico vengono controllate e migliorate da altri chatbot, spesso con ripetuti scambi di messaggi. Il gruppo dell'Eth ha anche condotto un'indagine preliminare per capire perché alcuni problemi non sono stati risolti da nessuno dei concorrenti. In alcuni casi sembra che ai modelli mancasse un'intuizione cruciale che avrebbe permesso di arrivare alla soluzione finale, mentre in altri l'approccio di base era corretto, ma i sistemi non sono riusciti cogliere tutti i dettagli.
F.Pavlenko--BTB